Теневой ИИ в компании
Пока руководство решает, внедрять ли ИИ, сотрудники его уже внедрили. Сами, без спроса, через личные аккаунты. Бухгалтер загружает выгрузку в чат, чтобы свести таблицу. Менеджер просит нейросеть переписать коммерческое, вставив его целиком вместе с ценами. У этого явления есть название — теневой ИИ, и за прошлый год оно перестало быть темой для безопасников.
Коротко
Теневой ИИ — это использование нейросетей в рабочих задачах через личные аккаунты, без ведома компании. По отчёту IBM за 2026 год, доля компаний, где утечка произошла с участием таких инструментов, выросла с 20 до 43 % за год, а сама утечка обходится примерно на 760 тысяч долларов дороже средней. Главная причина не в технологии: у 92 % компаний, переживших инцидент с ИИ, просто не было правил доступа к нему. Запреты не работают — сотрудник уходит в телефон. Работает разрешённый контур: понятный список того, чем пользоваться можно, и короткий документ, что туда загружать нельзя.
Что такое теневой ИИ
Термин построен по аналогии с «теневым ИТ» — так называли ситуацию, когда отделы заводили себе облачные сервисы в обход системного администратора. С нейросетями то же самое, только порог ещё ниже: не нужно ничего устанавливать и ни с кем согласовывать, достаточно открыть вкладку.
Теневой ИИ — это когда рабочая информация попадает в инструмент, о котором компания не знает и который она не контролирует. Чаще всего так:
- сотрудник открывает публичный чат под личной почтой и вставляет туда рабочий документ;
- подключает к рабочей почте или диску сторонний плагин «для продуктивности»;
- пользуется расширением браузера, которое читает страницу целиком, включая CRM;
- ставит на рабочий компьютер приложение, которое само ходит в интернет с данными.
Оговорка: само по себе использование нейросетей сотрудниками — не катастрофа и не повод для разбирательств. Проблема начинается там, где никто не знает, что именно ушло наружу.
Почему это происходит
Не из вредности. Три причины, и все понятные.
Так быстрее. Задача, на которую уходил час, делается за десять минут. Человек не взвешивает риски — он решает свою задачу.
Правил нет. Если в компании не сказано, чем пользоваться можно, а чем нельзя, сотрудник считает, что можно всё. Формально он прав: запрета не было.
Спросить страшнее, чем сделать. Если единственный ожидаемый ответ — «нельзя», вопрос не задают. Это главный механизм: чем жёстче позиция компании на словах, тем глубже уходит практика.
Что именно утекает
Люди обычно представляют утечку как взлом. Здесь механика другая и неприятнее.
Когда сотрудник вставляет текст в публичный чат, этот текст уходит на сторонний сервер. Дальше всё зависит от условий сервиса: в бесплатных и личных тарифах переписка часто может использоваться для улучшения моделей. И вот ключевой момент: данные, попавшие в обучение, нельзя удалить так, как удаляют файл с сервера. Запрос на удаление файла выполним. Запрос «выньте наши цифры из модели» — нет.
Что уходит чаще всего:
- выгрузки из CRM с именами и телефонами клиентов;
- коммерческие предложения с ценами и условиями для конкретных заказчиков;
- договоры целиком — «проверь, нет ли подвоха»;
- переписки с клиентами, скопированные для составления ответа;
- внутренние таблицы: себестоимость, маржа, зарплаты.
Оговорка: это не означает, что любой ИИ опасен. Корпоративные тарифы и решения на собственном контуре устроены иначе — там обучение на ваших данных отключено по договору. Разница не в технологии, а в том, какой аккаунт открыл сотрудник.
Что показали цифры
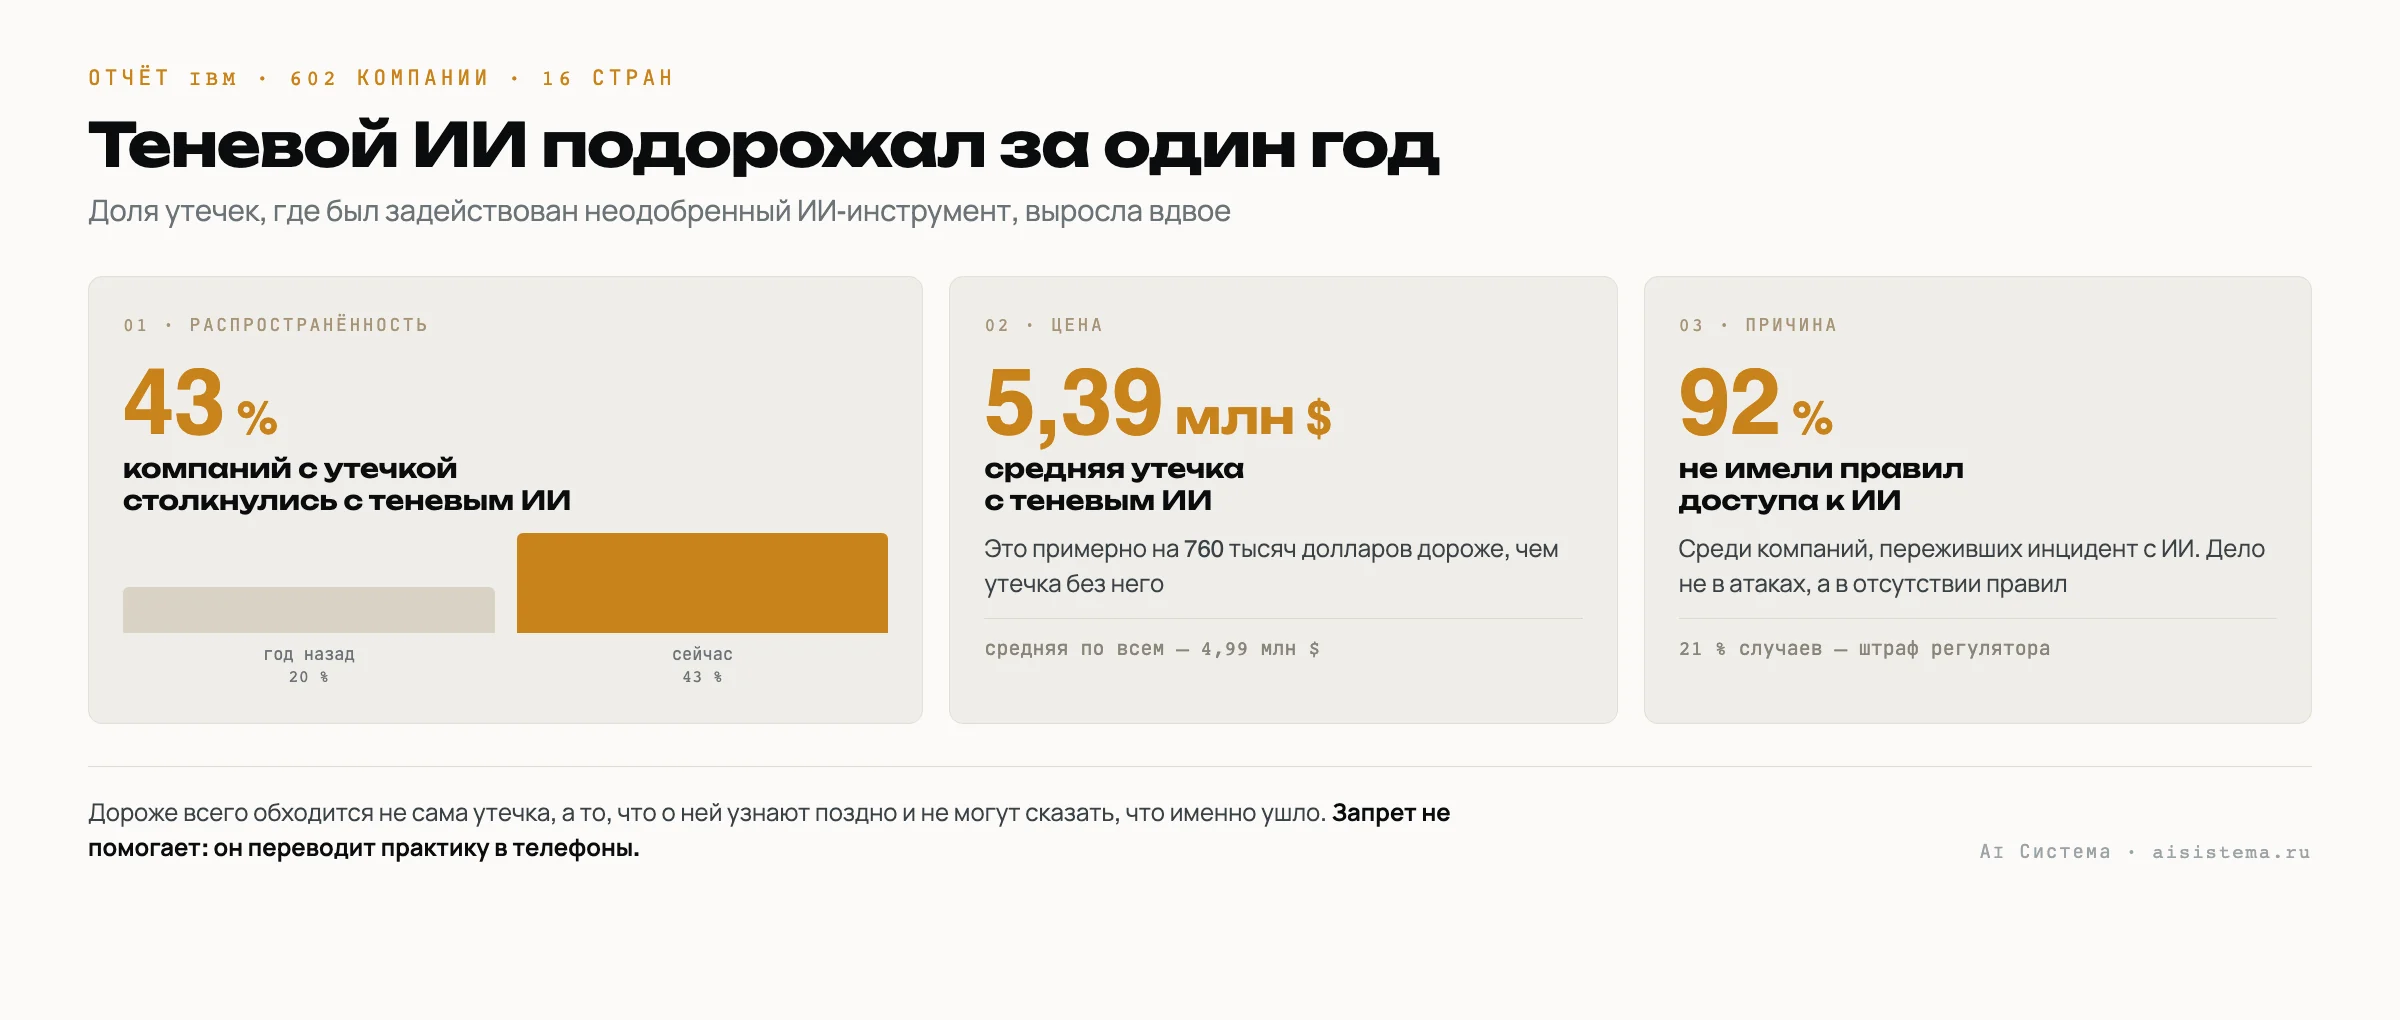
IBM ежегодно считает стоимость утечек данных. В отчёте 2026 года — данные по 602 организациям из 17 отраслей и 16 стран, собранные с марта 2025 по февраль 2026. Впервые теневой ИИ выделен отдельной строкой.
- 43 % пострадавших от утечки компаний столкнулись с инцидентом, где был задействован неодобренный ИИ-инструмент. Годом раньше таких было 20 % — доля выросла больше чем вдвое.
- Средняя утечка с участием теневого ИИ обошлась в 5,39 млн долларов против 4,99 млн по всем утечкам. Разница — около 760 тысяч долларов.
- 21 % таких случаев закончились штрафом регулятора.
- 92 % компаний, переживших инцидент с ИИ, не имели настроенного контроля доступа к нему.
Последняя цифра — самая важная. Она означает, что дело не в хитрых атаках. Дело в том, что никто не определил, кому и чем можно пользоваться.
Оговорка: это международная статистика, и суммы там корпоративного масштаба. Прямо переносить их на компанию из тридцати человек нельзя. Но пропорция переносится: дороже всего обходится не сама утечка, а то, что о ней узнают поздно и не могут сказать, что именно ушло.
Российская специфика
У нас к этому добавляются три вещи, которых нет в западных обзорах.
Доступ через обходные пути. Часть популярных сервисов работает из России нестабильно, и сотрудники идут через VPN или покупают доступ у перепродавцов. Это значит, что рабочие данные проходят ещё и через посредника, о котором компания точно ничего не знает.
Ответственность за персональные данные. С конца 2024 года в законодательстве появились оборотные штрафы за повторную утечку персональных данных — они привязаны к доле от выручки компании, с нижней и верхней границей, установленной законом. Отдельно введена уголовная ответственность за незаконный оборот персональных данных. Конкретные суммы зависят от состава нарушения и обстоятельств — это вопрос к юристу, а не к статье. Для нашей темы важно другое: выгрузка клиентской базы в публичный чат — это обработка персональных данных способом, который вы не описали ни в одном документе.
Отечественные модели. GigaChat и YandexGPT работают на российских серверах и подключаются по договору с юридическим лицом. Для компаний, у которых есть требования к хранению данных, это снимает значительную часть вопроса.
Оговорка: мы не юристы и не даём правовых заключений. Если у вас в работе персональные данные клиентов — сверяйтесь с юристом, а не со статьёй в интернете, включая эту.
Как понять, есть ли это у вас
Короткая проверка. Отвечайте честно — она для вас, а не для отчёта.
- Можете назвать, какими ИИ-сервисами пользуются ваши сотрудники в работе?
- Есть ли написанный документ, который говорит, что загружать можно, а что нельзя?
- Оплачивает ли компания хоть один корпоративный доступ к нейросети?
- Знаете ли вы, под какими аккаунтами работают сотрудники — личными или рабочими?
- Если завтра выяснится, что база клиентов ушла в публичный чат, сможете вы установить, кто и когда её вставил?
Если «нет» хотя бы на три вопроса — теневой ИИ у вас есть. Не потому что сотрудники плохие, а потому что ничего не мешает.
Что с этим делать
Главная ошибка — начать с запрета. Запрет не убирает практику, он делает её невидимой: человек просто перестаёт пользоваться рабочим компьютером и переходит на телефон. Вы теряете последнюю возможность понимать, что происходит.
Работает обратный ход — дать разрешённый путь, который удобнее подпольного.
Шаг 1. Посмотреть, что уже есть. Не расследование и не поиск виноватых. Спросите прямо, лучше анонимно: чем пользуетесь, для каких задач, что это вам даёт. Люди отвечают охотно, если не ждут наказания. В ответах обычно обнаруживается пара задач, которые стоит автоматизировать официально.
Шаг 2. Открыть один легальный доступ. Один оплаченный корпоративный аккаунт закрывает большую часть проблемы: у сотрудника появляется инструмент не хуже, но внутри контура компании.
Шаг 3. Написать короткий документ. Не положение на двадцать страниц — одна страница с тремя зонами. Можно взять эту таблицу как основу и поправить под себя:
| Зона | Что туда входит |
|---|---|
| Можно свободно | Черновики текстов и писем, идеи, планы, пересказ открытых материалов, перевод, вопросы по общим темам — всё, где нет ваших данных |
| Можно после проверки человеком | Тексты для клиентов, описания услуг, ответы на обращения, расчёты по обезличенным цифрам. Публикует и отправляет человек, не система |
| Нельзя никогда | Персональные данные клиентов и сотрудников, выгрузки из CRM, договоры, финансовые таблицы, себестоимость, пароли и доступы, всё под NDA |
Третья строка — самая важная. Её стоит проговорить вслух на планёрке, а не просто разослать файлом.
Шаг 4. Назвать ответственного. Один человек, к которому идут с вопросом «а это можно?». Пока такого человека нет, ответ по умолчанию — «сделаю молча».
Шаг 5. Вернуться через месяц. Не для контроля, а чтобы поправить список: какие-то запреты окажутся избыточными, какие-то задачи — наоборот, требующими внимания.
Оговорка: ни один из этих шагов не делает утечку невозможной. Они делают её видимой и управляемой — а это, судя по цифрам IBM, и есть основная разница в деньгах.
Как это связано с внедрением
Теневой ИИ — почти всегда признак того, что в компании есть процессы, которые просятся в автоматизацию. Сотрудник не от скуки вставляет выгрузку в чат: он закрывает задачу, на которую у него уходит слишком много времени.
Поэтому разговор о правилах и разговор о внедрении — это один разговор. Когда задача решена официально — выгрузка собирается сама, ответ клиенту готовит система внутри вашего контура, — потребность нести данные наружу исчезает сама, без запретов.
Частые вопросы
Что такое теневой ИИ простыми словами?
Это когда сотрудники используют нейросети для рабочих задач через личные аккаунты, а компания об этом не знает. Рабочие данные при этом уходят на сторонние серверы, и никто не может сказать, какие именно.
Чем это опасно для небольшой компании?
Тем же, чем и для большой, только дешевле обходится в абсолютных суммах. Главные риски: утечка клиентской базы, уход условий и цен к конкурентам через бывшего сотрудника, вопросы регулятора к обработке персональных данных.
Может, просто всё запретить?
Запрет переводит практику в телефоны и личные компьютеры, где вы её не видите вообще. По той же логике, по которой запрет мессенджеров не вернул переписку в почту. Работает связка: разрешённый инструмент плюс понятные границы.
Как узнать, что именно уже утекло?
Чаще всего — никак, и это главный аргумент в пользу того, чтобы начать сейчас. Если логов нет, восстановить историю невозможно. Поэтому первый шаг — не расследование, а разговор без последствий.
Безопасны ли российские нейросети?
GigaChat и YandexGPT работают на российских серверах и подключаются по договору с юридическим лицом — для компаний с требованиями к хранению данных это проще. Но сам по себе выбор модели не заменяет правил: вопрос не только в том, где сервер, а в том, кто и что туда отправляет.
С чего начать, если в компании тридцать человек?
С одного вопроса сотрудникам, что они уже используют. Дальше — один корпоративный доступ и страница правил. На всё уходит неделя, и это дешевле любого инцидента.
Источники
- IBM, Cost of a Data Breach Report 2026 — 602 организации, 17 отраслей, 16 стран, данные за март 2025 — февраль 2026: доля инцидентов с теневым ИИ, стоимость утечки, доля компаний без контроля доступа
- Федеральный закон от 30.11.2024 № 420-ФЗ — оборотные штрафы за повторную утечку персональных данных; Федеральный закон № 421-ФЗ — уголовная ответственность за незаконный оборот персональных данных
- Документация GigaChat и Yandex Cloud — условия работы с данными на российских серверах
Разберём ваш процесс
20–30 минут. Посмотрим, где теряются обращения, и скажем прямо, нужен вам агент или хватит пары настроек. Бесплатно.